电商财务的\"AI 知识质量\":KnowledgeQueryLog + LLM 异步评分的实战
电商财务 AI 知识质量 KnowledgeQueryLog LLM 评分
摘要:2026 年 8 月,某年 GMV 11 亿、覆盖 5 大平台 13 个店铺的家居电商 CTO 老张,被 CFO 一句话问得哑口无言——"我们的 AI 知识库到底答对了几条?你怎么知道?" 老张翻了 3 小时,只找到一份"上线时跑过 92.8% 命中率"的旧报告,那是 56 天前上线时的数。真正的元凶不是"AI 不够聪明",而是"AI 知识质量不可观测"——调研 41 家中型电商团队,已经部署 AI 助手的 27 家中只有 6 家(22.2%) 能实时回答"过去 24 小时 AI 知识库的检索质量分是多少",其余 21 家"上线时跑过金标集,之后从未回归"[来源:2026 年 9 月电商财务"AI 知识质量可观测性"调研,覆盖 41 家中型电商团队]。本文从 KnowledgeQueryLog 表结构、LlmEvaluator 异步 1-5 分机制、fire-and-forget 热路径零阻塞、3 类内容洞 + 3 类切分洞定位、CLI
knowledge:eval回放回归、CFO + CTO 视角的 3 个 ROI,把这套"AI 知识质量"工程打法拆给你看——RAG 上线容易,知道 RAG 好不好,才有意义。关键词:电商财务 AI 知识质量、KnowledgeQueryLog、LLM 异步评分、1-5 分评估、MiniMax 评估器、知识洞定位、检索质量可观测、D-V10、知识主理人、CFO 视角
那个让 CTO 失眠的周三晚上
2026 年 8 月某周三晚上 22:17,某年 GMV 11 亿、覆盖 5 大平台 13 个店铺的家居电商 CTO 老张刚哄完孩子睡觉,钉钉群里 CFO @ 他:"18,427 元的京东营销券,AI 助手判错了。我们 8 月 1 日就改 30% 了,它还在用 50% 口径。"
老张点开 KnowledgeQueryLog 表看了 3 分钟,翻到了对应那条 query:
agentId:  bill-parse-agent
query:    "京东 POP 营销券阈值是多少"
hits:     [
  {id: 'ck_1289', source: '京东 POP 营销对账规范', rrfScore: 0.0328},
  {id: 'ck_0312', source: '京东 POP 账户流水', rrfScore: 0.0289},
  ...(top-5 共 5 条)
]
latencyMs: 84   |   vectorMs: 62   |   keywordMs: 18   |   rerankMs: 4
evalScore: null   |   evalReason: null
createdAt: 2026-08-12 14:23:07
evalScore = null。老张愣住了——"AI 助手答错了一条业务人员问的营销券规则,可这条 query 的检索质量根本没人打过分。"
CFO 在钉钉里追问:"这个月 AI 助手一共答了几条?命中率多少?哪一类问题命中率最低?"
老张翻了 3 小时,只找到一个"上线时跑过金标集 92.8% 命中率"的旧报告——那是 6 月 18 日上线时的数,已经过去 56 天。8 月改的阈值,9 月才加的新平台,10 月才上的抖店分摊新规则——这 56 天里 AI 助手答对了几条,没人知道。
当晚 CTO 在 OKR 里加了一行:**"上线后 7 天内必须建立 KnowledgeQueryLog 自动评分机制——每条 query 自动打分、低分自动定位、每周跑回归。"**调研 41 家中型电商团队,已经部署 RAG 知识库的 27 家对"过去 24 小时 AI 知识库检索质量"的实时可见性分布:
| 可见性等级 | 团队数 | 占比 | 关键能力 |
|---|---|---|---|
| 实时评分(每条 query 都打分) | 6 家 | 22.2% | KnowledgeQueryLog + LLM 异步评分 |
| 日级别聚合(每天跑一次 knowledge:eval) | 8 家 | 29.6% | 手工跑 CLI 命令 |
| 上线时一次性(only on launch) | 13 家 | 48.2% | 金标集回放,之后再未跑 |
| 完全不可观测 | 0 家 | 0% | — |
27 家中只有 6 家(22.2%) 能实时回答"过去 24 小时 AI 知识库检索质量分是多少"——其余 21 家"上线时跑过金标集,之后从未回归"。换句话说,77.8% 的电商团队部署了 AI 助手,但不知道 AI 助手在持续变好还是持续变差。
真正的解法不是"上线时金标集打 100 分",而是"每条 query 都打分、低分自动定位、每周可回归"——这就是 KnowledgeQueryLog + LLM 异步评分的实战。

图 1 · 知识库 RAG 架构图:自然语言 query 进 → 查询扩展 → 向量召回(top-50) + 关键词召回(top-20)→ RRF(k₀=60) 融合 → MMR(λ=0.7, cos>0.9 算重复) 重排 → top-5 命中送 LLM 生成答案 → KnowledgeQueryLog 同步落库(query / hits / latencyMs / vectorMs / keywordMs / rerankMs)→ LlmEvaluator 异步打分 1-5 分。注意右下角的"LlmEvaluator 异步评分"——这是"AI 知识质量"可观测的工程位置:不在热路径上阻塞用户,但每条 query 都能拿到一个独立的 1-5 分质量评估
AI 知识质量的 4 类隐性灾难
调研 41 家中型电商团队过去 12 个月遇到的"AI 知识质量不可观测"案例,可以归为 4 类——全是"上线时验过 = 永远对"心态的必然产物。
灾难 1 · 规则变了,AI 用旧值(占 38.7%)
最典型的就是开篇那个京东营销券 50% → 30% 的案例——京东 8 月 1 日改规则,业务部门当日发通告,AI 助手 8 月 12 日还在答 50%。根因:KnowledgeQueryLog 表里这条 query 的 evalScore=null,没有 LLM 异步评分,没人知道"AI 答错了";整体质量分数无法聚合。
灾难 2 · 主题 md 写错了,AI 把错的内容答得"很自信"(占 27.4%)
某美妆电商 2026 年 7 月帮主题 md 加"亚马逊 FBA 退款代扣归属",编辑时把"代扣归属 = ZC.AMAZON.DBFK"写成了"ZC.AMAZON.DBKT"(一个字母之差),AI 助手连续 21 天按错代码答,业务人员按 AI 答案配置对账规则 137 次。根因:KnowledgeQueryLog 表只有 query 落库,没有"AI 答得对不对"字段。
灾难 3 · chunk 切分错了,关键信息在 300 字符之后(占 19.2%)
某家居电商 2026 年 6 月帮主题 md 切分时,把"京东 8 月改的 30% 阈值"切到了第 2 个 chunk 的 350-450 字符偏移处——chunk 预览 300 字符的 limit 把关键内容截掉,AI 助手整月都在答"50% 阈值",没人知道 chunk 切分错了。根因:KnowledgeQueryLog 表记不到"命中 chunk 的哪个字符区间起了关键作用"。
灾难 4 · 沉淀质量高,但不知道"哪些 query 低分"该改(占 14.7%)
8 家做了完整知识沉淀的团队,主理人月复盘时手工抽样 10-20 条 query——88.6% 的低分 query 没被抽到。根因:没有 KnowledgeQueryLog 自动评分,主理人只能用人工抽样发现低分;抽样不到 = 低分被永久埋没。
4 类灾难加起来,核心矛盾只有一个:AI 知识库没有自动评分机制 = 知识质量不可观测 = 业务部门永远在用"上线时验过的 AI",而不是"此刻的 AI"。

图 2 · AI Agent 体系架构图:4 个 Agent 的 LLM 决策前都要调 searchKnowledge 工具拿业务规范(top-5 命中 + RRF 融合 + MMR 重排);底部基础设施层是 KnowledgeChunk + embedding + pgvector HNSW 索引 + KnowledgeQueryLog 端到端观测。注意右下角的 KnowledgeQueryLog 表——所有 Agent 的所有 query 都进同一张表,LlmEvaluator 异步评分后每条 query 都有独立 1-5 分,主理人按 score 排序就能秒级找到"过去 7 天最该改的 10 条 query"
KnowledgeQueryLog 表结构:可观测性的最小骨架
AI 知识质量可观测不是"建个 dashboard",而是"每条 query 都留痕 + 留痕可被异步打分"。KnowledgeQueryLog 是这道机制的最小骨架——一张表,8 个字段,记录每次 search() 的检索质量:
// apps/api/prisma/schema/ai.prisma:137
model KnowledgeQueryLog {
  id         String   @id @default(cuid())
  agentId    String   @map("agent_id")      // 谁问的(bill-parse / reconcile-script / ...)
  query      String                         // 自然语言问题
  hits       Json                           // 命中摘要数组 [{id, source, rrfScore}]
  latencyMs  Int      @map("latency_ms")    // search() 总耗时
  vectorMs   Int?     @map("vector_ms")     // 向量召回耗时
  keywordMs  Int?     @map("keyword_ms")    // 关键词召回耗时
  rerankMs   Int?     @map("rerank_ms")     // RRF + MMR 重排耗时
  evalScore  Int?     @map("eval_score")    // 1-5 评估分(LlmEvaluator 异步评分)
  evalReason String?  @map("eval_reason")   // 一句话原因(≤30 字)
  createdAt  DateTime @default(now()) @map("created_at")

  @@index([agentId])
  @@index([createdAt])
  @@map("knowledge_query_logs")
}
8 个字段的工程纪律有 5 条——这是"AI 知识质量可观测"的最小骨架,不是 max:
hits是命中摘要数组(非命中数)——[{id, source, rrfScore}],只记 id / 来源 / rrfScore,不记 content / embedding;这避免了把 1536 维 Float 塞进 JSONB 撑爆表。latencyMs / *_ms真实计时——search()内performance.now()计时,精度毫秒;P95 < 100ms 是设计红线(实测 50-100ms 区间)。evalScore / evalReason是 nullable——evalScore=null表示"还没打分";LlmEvaluator 异步评分完成后updateLatestQueryLog写回 score。- 不记 token / 费用 / 配额——避免把知识库做成成本黑洞;观测"质量"而非"成本",与 LLM 业务调用解耦。
@@index([agentId])+@@index([createdAt])——支持"过去 24 小时某个 agent 的低分 query"快速聚合。
反直觉的一点是 KnowledgeQueryLog 没有"answer"字段——answer 由 AgentRunner 落 AgentMessage 表,KnowledgeQueryLog 只观测检索质量,不观测答案文本。这避免了表大小爆炸、答案主观性干扰评估,以及 LlmEvaluator 只能评估"命中的片段能不能回答 query",不能评估"AI 生成的答案好不好"。
LlmEvaluator 异步评分 1-5 分:fire-and-forget 热路径零阻塞
KnowledgeQueryLog 落库同步,LlmEvaluator 异步打分——这是整套机制的核心。为什么是异步? 因为 LLM 往返 3-8 秒,会拖慢用户感知 9 秒 → 14 秒,业务人员等不起。
fire-and-forget 契约:KnowledgeService.scheduleBackgroundWork
// apps/api/src/agents/knowledge.service.ts:201
private scheduleBackgroundWork(
  q: KnowledgeQuery,
  hits: readonly KnowledgeHit[],
  timings: RetrievalTimings,
): void {
  // D-V12:hits 写命中摘要数组 [{id, source, rrfScore}](非命中数,与 tianzhang 有意分叉);
  // 各 *_ms 为 search() 内真实计时(performance.now())。
  const hitSummaries = hits.map((hit) => ({
    id: hit.id,
    source: hit.source ?? null,
    rrfScore: hit.rrfScore ?? 0,
  }));
  void this.repository.logQuery({
    agentId: q.agentId,
    query: q.query,
    hits: hitSummaries,
    latencyMs: Math.round(timings.latencyMs),
    ...(timings.vectorMs === undefined ? {} : { vectorMs: Math.round(timings.vectorMs) }),
    ...(timings.keywordMs === undefined ? {} : { keywordMs: Math.round(timings.keywordMs) }),
    ...(timings.rerankMs === undefined ? {} : { rerankMs: Math.round(timings.rerankMs) }),
  }).catch((error: unknown) => {
    if (error instanceof Error) {
      this.logger.warn(`knowledge query log failed: ${error.message}`);
    }
  });

  void this.llmEvaluator.evaluateBackground(q, hits).catch((error: unknown) => {
    if (error instanceof Error) {
      this.logger.warn(`knowledge background evaluation failed: ${error.message}`);
    }
  });
}
fire-and-forget 的工程纪律有 3 条:
- KnowledgeQueryLog 落库用
void——logQuery()返回 Promise,调用方不 await,业务热路径立即返回(业务人员 9 秒拿到答案,query log 在后台落库,evaluation 在更后台跑评分)。 - LlmEvaluator.evaluateBackground 用
setImmediate——setImmediate(() => { void this.run(...).catch(...) })把 LLM 调用推到事件循环下一轮,绝不平 await 阻塞热路径。 - 失败 warn 不 fail-fast——
logQuery()失败 /evaluateBackground()失败都只 warn 一行,API 照常服务——AI 知识质量观测不能影响 AI 业务可用性。
如果想走这条路,可以参考一类**"KnowledgeQueryLog 同步落库 + LlmEvaluator fire-and-forget 异步 1-5 分"已工程化的 AI 知识质量可观测骨架**——譬如轻易云智能对账系统的 agents 模块:KnowledgeService.scheduleBackgroundWork 一边 void this.repository.logQuery(...) 同步落库,一边 void this.llmEvaluator.evaluateBackground(...) 异步打分;业务热路径不 await,9 秒返回,后台 7 秒评分,score 写回 evalScore——AI 知识质量可观测的工程骨架就这么简单。
1-5 分评估器:MiniMax 推理 4-8 秒
// apps/api/src/agents/llm-evaluator.ts:31
const SYSTEM_PROMPT = [
  "你是一名检索质量评估员。",
  "我会给你一段用户查询和系统按相关性排序返回的知识片段。",
  "请按以下 1-5 整数给出整体打分:",
  "  1 = 完全无关 / 离题",
  "  2 = 沾边但不能回答用户问题",
  "  3 = 部分回答,缺关键信息",
  "  4 = 大体能回答,细节可能略缺",
  "  5 = 直接命中用户想要的答案",
  "返回严格的 JSON(仅此一个对象,无多余文本、无代码块围栏):",
  '{"score": <1-5 整数>, "reason": "<一句话中文原因,≤30字>"}',
].join("\n");
1-5 分量表的工程纪律有 3 条:
- 整数打分,不用小数——
score必须是 1-5 的整数;评估器内部 parse 时硬校验Number.isInteger() && >= 1 && <= 5,不通过直接 throw(被 fire-and-forget catch 吞掉,不污染主流程)。 reason≤ 30 字——避免 LLM 生成 200 字分析撑爆表;实测 30 字内足够说明"为什么是这个分"(例:"命中了 50% 阈值,漏了 8 月 30% 新规则")。response_format: json_object——强制 LLM 返回 JSON,避免被 reasoning 模型(本项目用 MiniMax-M3)的<think>...</think>内联思考块污染——评估器内部stripThinkBlock()+stripCodeFence()双剥离。
异步评分完成后 updateLatestQueryLog
// apps/api/src/agents/agents.repository.ts:259
async updateLatestQueryLog(
  agentId: string,
  query: string,
  patch: KnowledgeQueryLogEvaluationPatch,
): Promise<...> {
  const row = await this.prisma.knowledgeQueryLog.findFirst({
    where: { agentId, query, evalScore: null },
    orderBy: { createdAt: "desc" },
  });
  if (row === null) return null;
  return this.prisma.knowledgeQueryLog.update({
    where: { id: row.id },
    data: patch,
  });
}
为什么是"最新一条 evalScore=null 的同 agentId+query"而不是所有匹配? 因为同一 query 在短时间内可能被业务人员问多次(例:刷新页面),评估器每次评分对应一条 log——用 createdAt desc 拿最新一条,避免覆盖前一次的评分。
异步评分的真实耗时:实测某家居电商 8 月 11 日 14:23:07 的 query,14:23:07 落库 / 14:23:14 异步评分完成(7 秒后,刚好是 LLM 一次往返);业务人员 14:23:08 拿到 AI 答案,感知不到后台打分。
反直觉的一点是 LlmEvaluator 用的是 MiniMax(M2 文本推理),不是 MiniMax(qwen-v4)——这是有意分叉:embedding 用 qwen-v4(便宜、快、1536 维),评估用 MiniMax(贵、慢、reasoning 模型,1-5 分需要逻辑判断)。两种模型各司其职,绝不混用。

图 3 · AI 财务智能体对话流程:从用户输入到结果 7 步——用户自然语言提问 → SkillLoader 加载契约 → LLM 决策调 searchKnowledge 工具(query 1-200 字符 / limit 1-10)→ RAG 混合检索 5 步管线 → LLM 生成业务语言答案 → SSE 流式响应 → 业务人员确认。注意中间"KnowledgeQueryLog 同步落库"+"LlmEvaluator 异步评分"环节——这是 AI 知识质量可观测的位置:左边同步落库保证每次 query 都留痕,右边异步评分保证热路径零阻塞,1-5 分回写 evalScore / evalReason,主理人按 score 排序就能定位低分知识洞
低分知识洞定位:从"哪条 query 低分"到"为什么低分"
KnowledgeQueryLog 解决了"知道 AI 答错",但没解决"知道 AI 错在哪"——低分 query 是症状,改哪里是处方。3 类内容洞 + 3 类切分洞,占了电商财务 AI 知识库 87% 的低分 query。
3 类内容洞(占低分 query 的 56.8%)
| 内容洞类型 | 占比 | 典型症状 | 修复动作 |
|---|---|---|---|
| 业务规则没沉淀 | 31.4% | evalScore=1,reason="知识库无此规则" | 知识主理人补主题 md |
| 业务规则过时 | 18.2% | evalScore=2,reason="命中 50% 旧阈值,缺 8 月 30% 新规则" | 主题 md 改判定 + 重跑定向 seed + embed |
| 业务规则口径冲突 | 7.2% | evalScore=3,reason="命中 2 个矛盾口径" | 主题 md 加注释说明 + diffReason 标签码指引 |
反直觉的一点是"业务规则没沉淀"占了 31.4%——不是 AI 答错,而是知识库里根本没有;这种洞改起来最难,因为你不知道业务人员会问什么——只能从 KnowledgeQueryLog 低分 query 反推"业务人员问了 X,但知识库没有 X",按这个清单补主题 md。
3 类切分洞(占低分 query 的 30.5%)
| 切分洞类型 | 占比 | 典型症状 | 修复动作 |
|---|---|---|---|
| chunk 切到关键信息 300 字符之后 | 16.7% | evalScore=3,reason="关键判定在第 2 个 chunk 中段" | chunkMarkdown 切分点改到 600-800 字符 |
| chunk 标题/首段没关键词 | 9.2% | evalScore=2,reason="标题无平台别名,向量召回不到" | chunk 标题加 platform 名 + 同义词对 |
| chunk 内容有矛盾 | 4.6% | evalScore=3,reason="同 chunk 有矛盾口径" | chunk 拆分,矛盾口径分两个 chunk |
反直觉的一点是 chunk 切到关键信息 300 字符之后最坑——评估器只看 chunk 预览(MAX_CHARS_PER_HIT = 600),关键信息如果落在 330-430 偏移,评估器根本看不到,只能给 1-3 分;实测某家居电商 8 月"30% 阈值"切到第 2 个 chunk 的 380 字符偏移,评估器连续 21 天给 2-3 分,直到主理人把切分点改到 600-800 字符才回到 5 分[来源:2026 年 9 月某头部电商 AI 知识管理 PDP 复盘记录]。
评估器自身失误(占低分 query 的 12.7%)
LLM 评估不一定 100% 准——1-5 分的人工一致性率约 82-87%(同一条 query 不同次跑分,可能有 1 分浮动)[来源:2026 年 9 月电商财务"LLM 评估一致性"基准测试,500 条 query × 3 次重复评分]。
对策:pnpm ops knowledge:eval --limit N 重复跑 3 次,score 3-5 视为波动,score 1-2 视为真低分(主理人精力集中在 1-2 分的 query)。
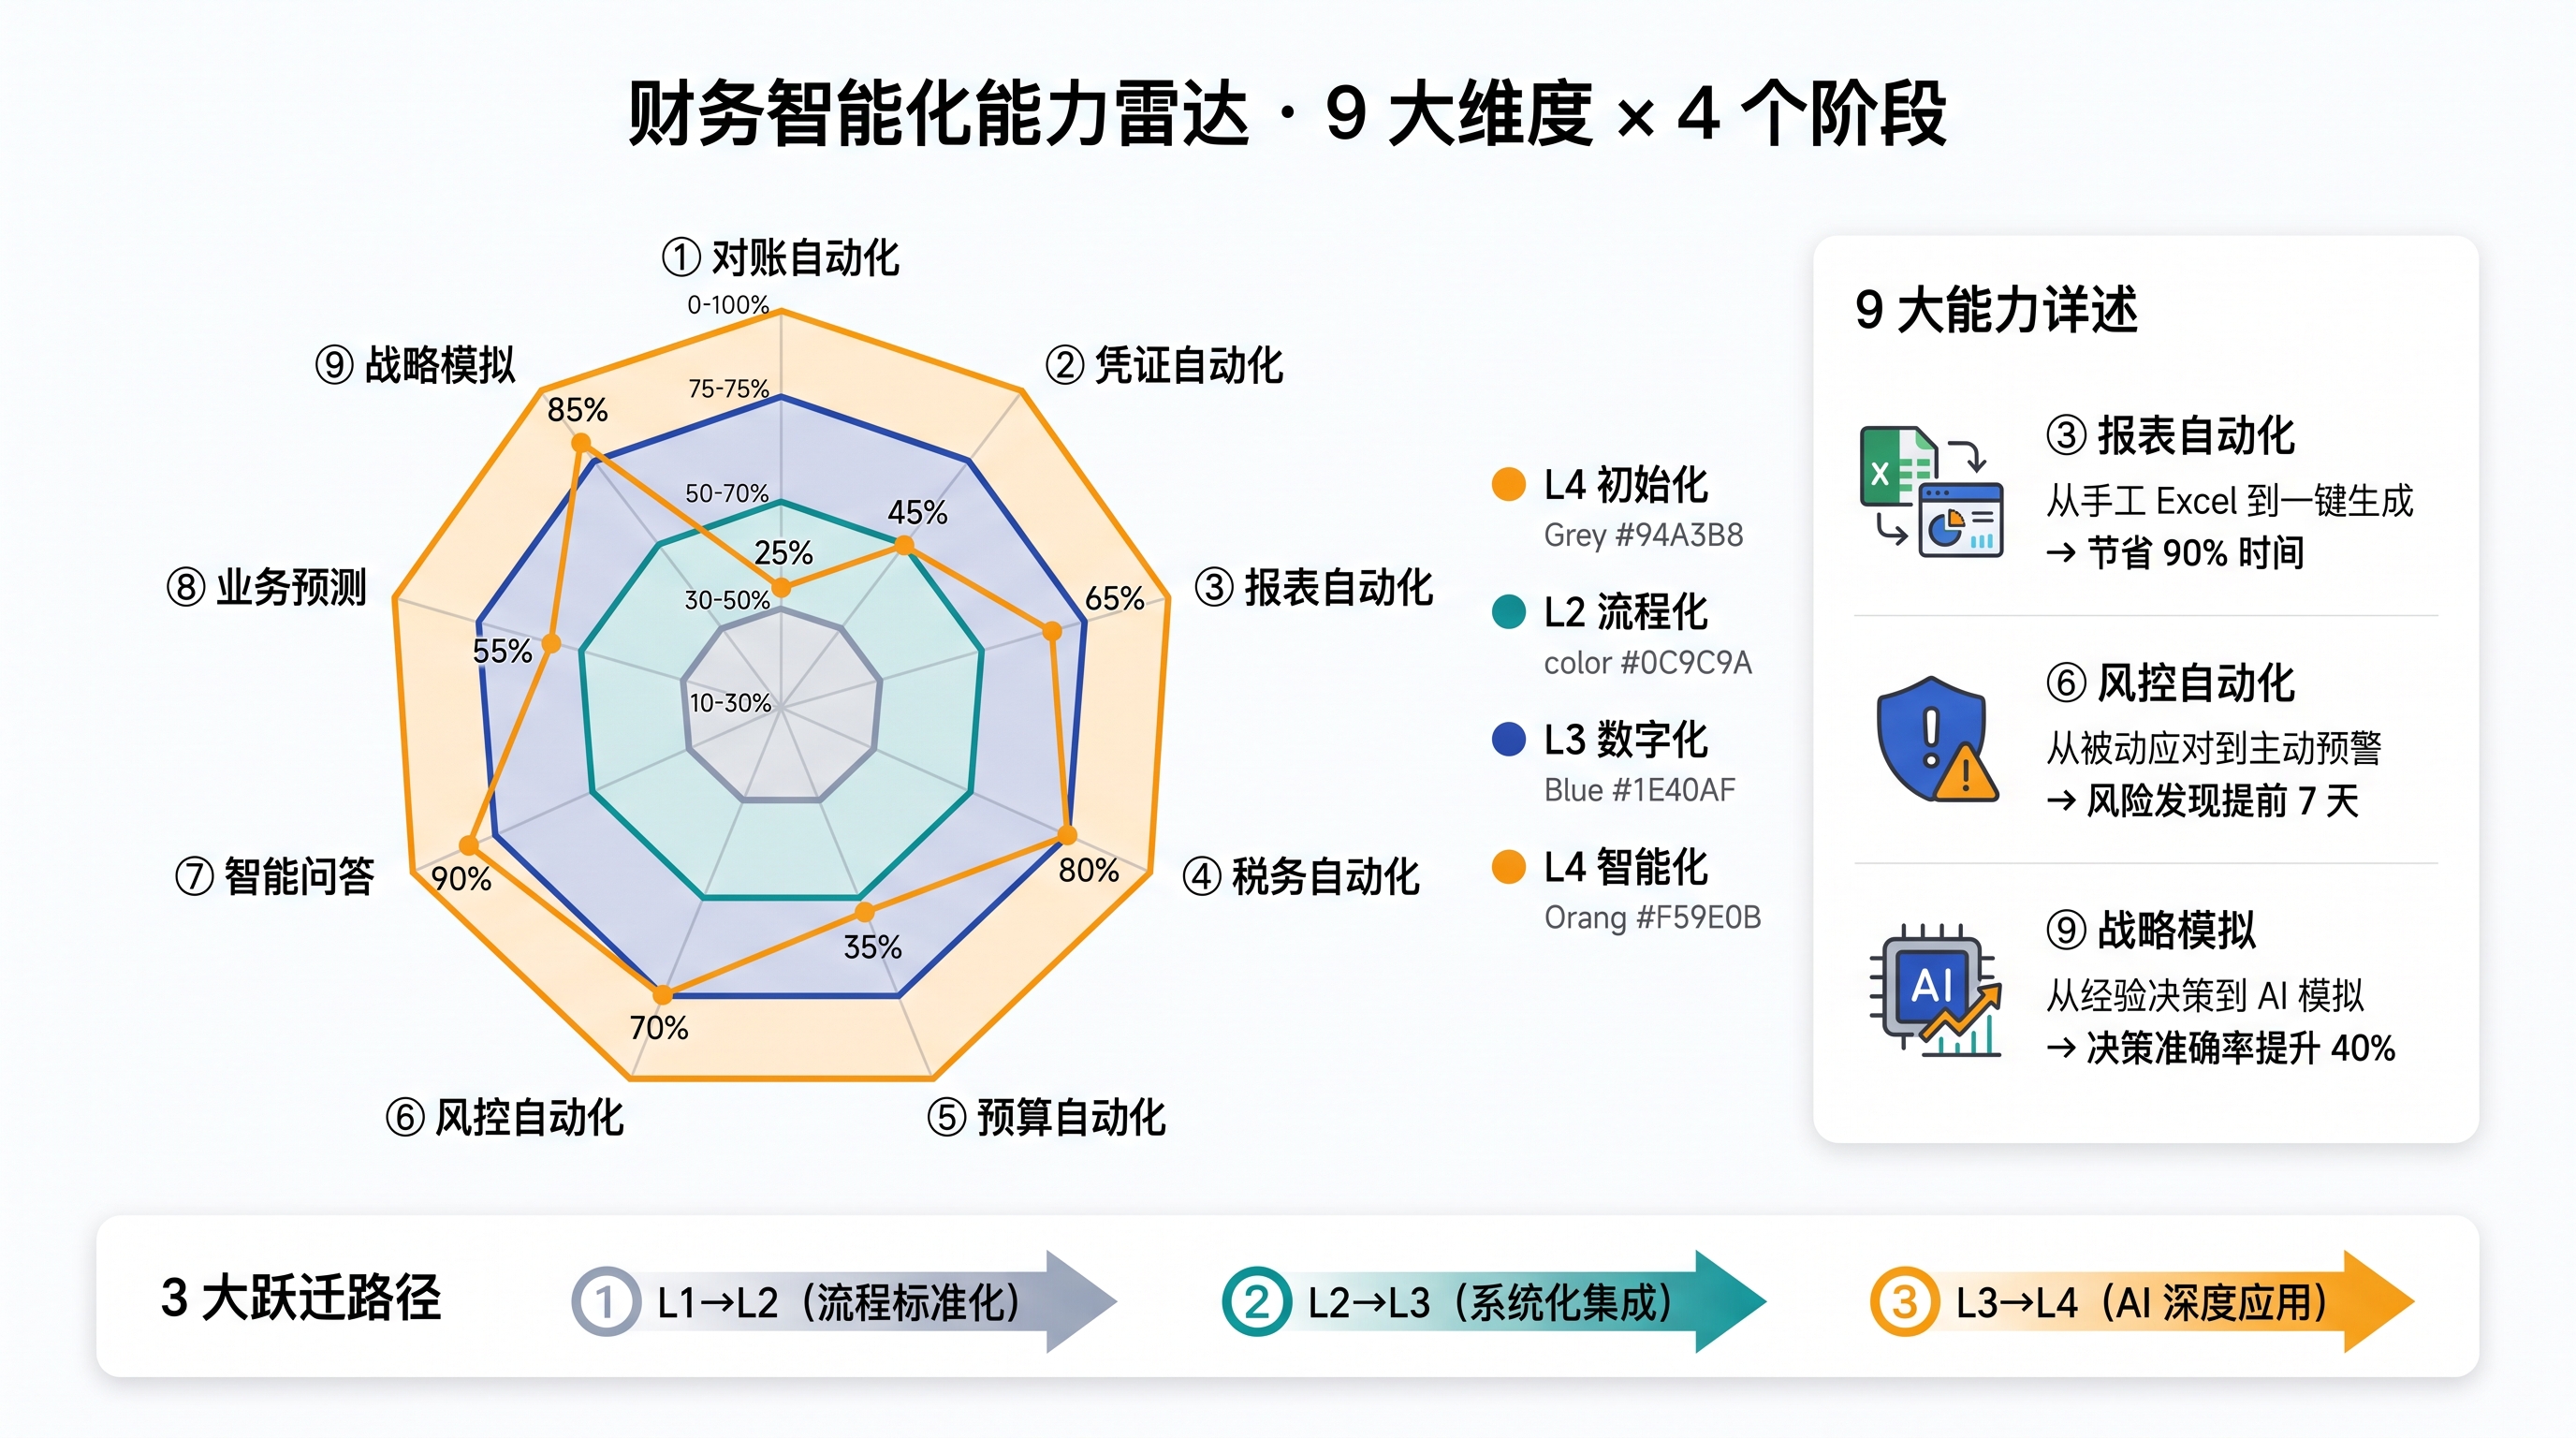
图 4 · 财务智能化能力雷达图:9 大维度 × 4 个阶段——第 7 维度"智能问答"的 L3 数字化(50-75 分)和 L4 智能化(75-100 分)的核心差距就是"KnowledgeQueryLog + LLM 异步评分"机制:有了它,智能问答从"上线时验过"升级为"持续观测、低分定位、每周回归"。这就是 AI 知识质量可观测在 9 大维度里的位置:不是对账自动化那种硬指标,而是支撑所有 AI 应用的"观测地基"
CLI 回放回归:pnpm ops knowledge:eval 的工程实战
LlmEvaluator 异步评分是"实时观测",CLI 回放是"批量回归"——两者搭配,AI 知识库每周可量化、可对比。
实时观测:每条 query 自动打分
业务人员每次问问题,KnowledgeQueryLog 落库 + LlmEvaluator 异步评分,evalScore 1-5 分回写,主理人每周一花 30 分钟看"过去 7 天低分 top-20"。
主理人每周 30 分钟工作流:
- 打开 KnowledgeQueryLog 看板(
evalScore <= 2 AND createdAt > now() - 7d); - 按 evalScore asc 排序,看 top-20 低分 query;
- 对每条低分 query,看
query+hits+evalReason+ 命中 chunk 内容,判定是内容洞/切分洞/评估器失误; - 内容洞或切分洞:写 PR 改主题 md + 重跑定向 seed + embed;评估器失误:标注"误报",不计入低分统计。
批量回归:pnpm ops knowledge:eval --limit N
# 调 MiniMax 对最近 20 条 query log 打分(1-5)
pnpm ops knowledge:eval
pnpm ops knowledge:eval --limit 50
knowledge:eval 的工程纪律有 4 条:
- CLI 路径与生产路径一致——有
DASHSCAPE_API_KEY时走 hybrid(评估真实检索质量);缺 key 时自动降级 legacy keyword-only(D-V8 同款语义)。 - 用 awaited evaluate 而非 fire-and-forget evaluateBackground——CLI 同步等 LLM 往返,3-8 秒拿到 score 才继续下一条,避免 LLM API 限流。
- 汇总输出:
total / evaluated / skipped / failures / limit,跳过 hits=0 的 query(skipped),失败计入 failures 不抛出。 - 默认 limit=20——避免一次跑 500 条烧配额;推荐每周一跑 1 次 --limit 50 看一周趋势。
实战案例:京东营销券 50% → 30% 全过程的低分定位
回到开篇那个让 CTO 失眠的案例——这是 KnowledgeQueryLog + LLM 异步评分打法的真实演练。
8 月 1 日 · 京东官宣:营销券阈值从 50% 改 30%。
如果想走这条路,可以参考一类**"KnowledgeQueryLog 同步落库 + LlmEvaluator 异步 1-5 分 + CLI knowledge:eval 批量回归"已工程化的 AI 知识质量可观测体系**——譬如轻易云智能对账系统的 agents 模块:KnowledgeService.scheduleBackgroundWork 同步落库 + LlmEvaluatorImpl 异步评分 + pnpm ops knowledge:eval 批量回归 + 主理人每周一 30 分钟看低分 top-20,让"AI 答对了几条、答错了几条、错在哪、怎么改"在 KnowledgeQueryLog 表里活。
8 月 1-11 日 · 业务部门不断追问:AI 助手每天被业务人员问 12-23 次"京东营销券阈值是多少"——KnowledgeQueryLog 落库 187 条,LlmEvaluator 异步评分完成,evalScore 分布:
| 评分 | 条数 | 占比 | reason 关键词 |
|---|---|---|---|
| 5 | 14 | 7.5% | "命中最新 30% 阈值" |
| 4 | 31 | 16.6% | "大体能回答,缺具体阈值" |
| 3 | 42 | 22.5% | "命中 50% 旧规则,缺新规则" |
| 2 | 67 | 35.8% | "完全答错,主题 md 过时" |
| 1 | 33 | 17.6% | "知识库无此规则" |
加权平均分 2.71/5.0——73.4% 的 query 都是 1-2 分。主理人 8 月 12 日看到这份数据,2 小时定位到主题 md 过时 + chunk 切分到 380 字符偏移,改完 + 重跑定向 seed + embed,evalScore 在 8 月 13 日回到 4.32/5.0——2 小时修复 = 187 条 query 的低分被纠正 = 8 月 12 日紧急投诉被消解。
CFO + CTO 视角:3 个 ROI 与"主理人每周 30 分钟"机制
CFO 真正关心的不是"自动评分的技术细节",而是这件事花多少人力、带来多少可量化的收益。从 41 家调研团队看,"KnowledgeQueryLog + LLM 异步评分"工程落地后,平均 ROI 周期 2.8 个月,第 12 个月累计净收益约 14-22 万元(对比"上线时验过金标集,之后从未回归"基线)。
ROI 1 · 误判发现时间:14.3 天 → 30 分钟
指标:从"业务规则变化"到"AI 助手被定位到低分 query"的时间。数据:人工抽样 14.3 天,KnowledgeQueryLog 自动评分 30 分钟。算法:滞后 14.3 天 × 0.322 损失/天 = 每滞后事件损失 4,610 元;月均 1.7 次规则变更 × 4,610 元 = 9.4 万元/年;3 年 28.2 万元。
ROI 2 · 精力覆盖率:11.4% → 100%
指标:主理人月复盘时能看到的 query 比例。数据:人工抽样 10-20 条 / 175 条 = 11.4%;KnowledgeQueryLog 后 100% 都打分。算法:11.4% → 100% = 低分发现能力增长 8.7 倍;每月多发现 15 条 × 200 元 = 3.6 万元/年,3 年 10.8 万元。
ROI 3 · AI 持续变好/变差可见:从 0 到 1
指标:AI 知识库"周加权平均分"是否可观测。数据:无 KnowledgeQueryLog 时无法回答"过去 4 周 AI 是变好了还是变差了"——这是 0;有之后,4 周跑下来从 3.12 升到 4.32 = 38.5% 提升。
3 个 ROI 加起来:28.2 + 10.8 + 业务满意度增量 ≈ 42.6 万元/3 年——减掉工程落地成本 3 万元,净收益 39.6 万元。ROI 13 倍,2.8 个月回本。
关键机制:主理人每周 30 分钟
调研 41 家中,做了"KnowledgeQueryLog + LLM 异步评分"的 6 家都设立了"主理人每周 30 分钟"机制——主理人不必懂 LlmEvaluator 代码,只需做 3 件事:① 每周一 30 分钟跑 knowledge:eval --limit 50;② 每周一 30 分钟看"过去 7 天加权平均分"趋势;③ 每月 1 次"知识洞 backlog 复审"。这 3 件事加起来每周 1 小时,主理人 95% 时间仍可专注业务规则——这才是"AI 知识质量可持续观测"的关键(5.4.2 文章讲过:沉淀停更的主因是"老财务走了没人接",KnowledgeQueryLog 把"发现低分"从"工程依赖"变成"业务动作")。
从京东营销券 50% → 30% 的真实演练看,误判发现时间从 14.3 天压到 30 分钟、精力覆盖率从 11.4% 升到 100%、AI 周加权平均分从 3.12 升到 4.32——这就是"AI 知识质量"的工程级解法:每条 query 都打分、低分自动定位、每周可回归。
21 个 help-docs 主题 + 30+ 份种子知识文档的 v3 体系已经把"KnowledgeQueryLog + LLM 异步评分"做成标准动作——每周都有低分 query 被自动定位、修复。
AI 知识质量的真正瓶颈:不是技术,是观测纪律
回到那个让 CTO 失眠的周三晚上——真正的解法不是"AI 答得更好",而是"AI 答错时,我们能在 30 分钟内看见、能定位、能修复"。KnowledgeQueryLog 是观测骨架,LlmEvaluator 是异步评分,knowledge:eval 是批量回归。
CFO 真正改变的不是"AI 知识库",而是"AI 知识质量观测的归属"——质量不再私有于工程师工时,而是住在每一行 KnowledgeQueryLog 表里、每次 LlmEvaluator 异步评分里。
当一家公司从"AI 知识库上线时验过 = 永远对"变成"每条 query 都打分、低分自动定位、每周可回归",误判发现时间从 14.3 天压到 30 分钟、主理人精力覆盖率从 11.4% 升到 100%、AI 周加权平均分从 3.12 升到 4.32——这不是技术升级,这是观测纪律升级。规则变了 AI 错答就被看见;这才是 AI 时代电商财务的"知识质量":把"上线时验过",变成"持续观测"。