post-deploy-knowledge:部署即知识库同步的自动化
post-deploy-knowledge:部署即知识库同步的自动化
摘要:AI 系统的知识库不是「写一次吃一辈子」,它会随代码迭代、随业务更新、随 md 文档修正而持续变化。这篇文章不讲 RAG 原理,而是讲一个更接地气的问题:怎么让「拉代码 + 重启服务」一行命令搞定知识库更新,让运维不需要关心这次改的是 md、是 seed、还是 schema 注释?答案是一个 70 行的 Node 脚本 + 一份调用纪律:post-deploy-knowledge。
关键词:post-deploy-knowledge、知识库同步、自动化、部署、AI 工程、RAG
一次事故复盘:知识库"过期"是怎么被发现的
2026 年 9 月 11 日那周,AI 财务智能体在回答「京东 POP 售后服务单的核算项目是什么」时给了一个旧版本的答案:它把售后服务单归到了 ZC.JDPOP.SHFWD,但财务已经在两周前把这一项合并到了 ZC.JDPOP.QTFY(其他费用兜底)。开发同学查了一遍,发现原因是代码里 seeds/knowledge.ts 的相关 chunk 早就更新过了,但生产环境的 KnowledgeChunk 表里仍是旧版本——上一次部署时,知识库同步这一步被跳过了。
这不是孤立问题。在引入 post-deploy-knowledge 之前,"知识库更新"是部署流程中一个靠人工记忆的步骤:开发改完 seed 或 md 后,要在 PM2 重启之前手动跑一下 pnpm ops knowledge:embed,否则重启后 AI 智能体还是用旧数据回答。这个步骤在大多数时候会被忘掉,原因很简单——它不像 pnpm db:migrate 那样会因 schema 不匹配而报错,它静默地"过期"。
问题的根源不是流程纪律,而是架构:知识库有两个来源(TypeScript seed 与 md 文件)、三种状态(内容未变、内容已变、embedding 未计算)、四个调用入口(手动、CI、PM2 restart、Docker),但没有一个统一的"deploy-time"管道把它们串起来。
2026 年 9 月 20 日的大清理把所有非知识库 seed 都删掉之后,这件事反而变得更紧迫了:现在 apps/api/prisma/seeds/ 下只剩两个 seed 文件——seeds/knowledge.ts 和 seeds/help-docs-knowledge.ts,前者是"硬编码知识",后者是"扫描 help-docs md 的知识"。整个 seeds 目录现在就是为了知识库同步存在的。这也让 post-deploy-knowledge 这个自动化机制成了「部署流程的必要组成部分」而不是「可选补丁」。
下面把这套机制的三个核心设计讲清楚:双通道灌装、来源隔离、embedding fire-and-forget。
一、双通道灌装:A 通道 + B 通道的"知识分类"
AI 系统的知识库按"承载形式"分两类,它们在系统里的角色完全不同:
| 通道 | 来源 | 作用 | 典型受众 |
|---|---|---|---|
| A 通道 | apps/api/prisma/seeds/knowledge.ts(TypeScript 硬编码) | 业务专家手动维护的"权威知识",如核算项目标准目录、京东 POP 账单格式 | bill-parse-agent、reconcile-script-agent、expense-allocate-agent |
| B 通道 | apps/api/src/help-docs/content/*.md(Markdown 文件) | 业务功能帮助文档,自动扫描 + frontmatter 元数据 + 字段表自动解析 | general-assistant(通用 AI 助手)+ 业务页面帮助弹窗 |
A 通道是机器友好的——它本质上是 TypeScript 数组,每个元素是一个 KnowledgeDocSeed,包含 title、metadata、chunks 三段。这些 chunks 是业务专家人工撰写的高密度知识,强调"关键词密度优先于行文流畅"——因为它要被向量化、被检索、被 LLM 作为上下文消费。
B 通道是人机双友好的——它本质上是 Markdown,每个 md 既要被 AI 检索(进知识库),也要在产品页面的"帮助弹窗"里展示给业务人员看(如《京东 POP · 账户流水账单》)。这种"一份文档两个用途"的设计是 v3 重构后引入的:避免文档分散在 seed、md、产品提示文案三处。<img> 标签里的 frontmatter 字段(topic、category、platform、billType、agentIds)决定了它会被哪些 Agent 看见,以及在哪个产品页面挂帮助弹窗。
两通道的同步入口是同一个:apps/api/prisma/seed-knowledge-only.ts。它顺序调用 seedKnowledge(A 通道)+ seedHelpDocsKnowledge(B 通道),不传任何参数、不做内容过滤——属于"全量重建"语义。每次部署都重写一遍 KnowledgeDocument / KnowledgeChunk 内容,由 API 启动时 bootstrap.runOnBootstrap 自动补算 embedding。
这种"全量重建 + 自动补算"的代价是每次部署会有几十毫秒到几秒的 embedding 计算开销,但收益是:知识库永远是最新的,不需要任何"我改了哪里要同步跑一下"的人工记忆。
下面这张是整个部署 + 异步任务的架构图,post-deploy-knowledge 处在 PM2 重启与 API 启动之间的那个"知识同步"环节:

二、来源隔离:deleteMany 只删自己的 8 个标题,不动其他数据
这是 post-deploy-knowledge 在工程上最微妙的设计:知识库 seed 一定要"知道自己的边界在哪里"。
如果跑一个"灌知识"的脚本结果把 users 删了、把 shops 清了,那就成了"知识同步事故"——远比"知识过期"严重得多。2026 年 9 月 20 日那次大清理后,seeds 目录里只剩下两个文件,看起来很干净,但它们对数据库的写入权限是 "KnowledgeDocument / KnowledgeChunk 全表"——理论上写错一个 where 子句就可能误清库。
来源隔离是两道闸:
第一道闸:物理隔离。 seedKnowledge 只对 KnowledgeDocument 做 deleteMany({ where: { title: { in: titles } } }),其中 titles 是脚本里硬编码的 8 个标题("核算项目规范""京东 POP 账单格式"等)。它不传任何外键、不触碰 User / Shop / BillRow 等业务表。即使 createdById 外键校验失败,函数也会抛错而不是回退到"全表 delete"——这是被设计强制要求的。
第二道闸:来源标签。 B 通道的 seedHelpDocsKnowledge 用 source: 'help-docs' 作为 KnowledgeDocument 行的"来源标签",deleteMany({ where: { source: 'help-docs' } }) 只删自己产生的文档,不会动 A 通道创建的、用户手动写的、或人工运营添加的 KnowledgeDocument。这就是"用元数据做手术刀"的典型例子——比起物理隔离(每个表独立),来源标签(在同一表里靠字段区分)更灵活,但也更依赖纪律:每个 seed 函数的 deleteMany 必须带 source / title 过滤,不能写"全表 delete"。
来源标签的存在还带来一个意外的副作用——A 通道和 B 通道的 chunk 在 RAG 召回时是混在一起的(KnowledgeChunk 没有"通道"列),但 KnowledgeDocument 级别的 agentIds 过滤足以让 Agent 各自看到自己的"知识子集"。例如 bill-parse-agent 看到 A 通道的硬编码知识(如何识别账单),而 general-assistant 看到 B 通道的帮助文档(如何操作产品)——这两类知识在 Agent 工具层面就是按 agentIds 隔离的,运维不需要做额外配置。
下面这张异步任务架构图展示了同步完成后,bootstrap 如何把"无 embedding 的 chunk"分批推给 EmbedderInitializer:

三、embedding fire-and-forget:API listen() 先返回,bootstrap 后台跑
知识库同步这件事还有一个"半成品期"的问题:KnowledgeDocument / KnowledgeChunk 内容同步完成 ≠ embedding 计算完成。前者是数据库的 INSERT / UPDATE 操作,几十毫秒搞定;后者是调用 DashScope 的 text-embedding-v4 API(1536 维向量),按 chunk 数量线性耗时——8 个文档 60 个 chunk 大概需要 30 秒到 2 分钟(取决于 API 响应速度)。
如果在 PM2 重启之前同步等 embedding 跑完,部署会被卡 1-2 分钟;如果不等,新版本 API 启动后用户问 AI 助手,召回的 chunk 没有 embedding 是匹配不上的。
解决方案是 D-V7:fire-and-forget 后台执行。看 apps/api/src/main.ts:68-79 的真实代码:
// D-V7:API listen() 先返回,后台补算 fire-and-forget,不得 await 或前置。
setImmediate(() => {
  void (async () => {
    try {
      const initializer = app.get<EmbedderInitializer>(EMBEDDER_INITIALIZER);
      await initializer.runOnBootstrap();
    } catch (error: unknown) {
      const reason = error instanceof Error ? error.message : String(error);
      bootstrapLogger.warn(`knowledge embedding backfill failed: ${reason}`);
    }
  })();
});
关键设计有四条:
- listen() 必须在 embedding 之前完成:用
setImmediate让 Node.js 把 callback 推到事件循环下一轮再执行,API listen() 在这一轮内已经返回端口绑定。 - 不得
await或前置:bootstrap 失败不能阻塞 API 启动,最多写一条 warn 日志。embedding 是"提升"不是"门槛"。 - fire-and-forget 也不裸奔:包了一层
try/catch+void (async () => {})(),避免 unhandledRejection 把 Node 进程搞崩。 - 失败兜底(1536 维全零向量):如果某批 chunk 调 DashScope 失败(网络/API 限流),
EmbedderInitializer会把这批 chunk 写 1536 维全零向量 +embeddingStatus='failed',绝不写 NULL。召回 SQL 以embeddingStatus='ready'硬过滤,这些"失败的 chunk"不会被误命中(NULL 会被某些向量检索函数当默认值匹配,全零向量不会)。这个设计在apps/api/src/agents/embeddings.initializer.ts:11-13有完整的代码注释。
防死循环的设计也很关键:每批 chunk 取回后,如果整批 embedding 都失败,循环不能反复把同一批记录取回——所以 EmbedderInitializer 维护了一个 failedThisRun Set,过滤掉本轮已失败的 chunk 后再取下一批。这样最坏情况是跑一轮就退出,不会卡死。
对运维的实际意义:部署流程不再需要任何"等 embedding 跑完"的步骤。bash dev-ops/deploy.sh 跑完后立即可用,第一批用户提问会得到"知识库稍后生效"的体验(embedding 在后台跑),2 分钟内全部就位。这是一种主动的"最终一致性"——比"必须等完全就绪才能用"友好得多。
四、调用入口的四个独立通道
post-deploy-knowledge 有四个互不依赖的入口,它们各服务一类使用场景:
| 入口 | 调用者 | 时机 |
|---|---|---|
bash dev-ops/deploy.sh | 一键部署脚本 | PM2 restart 之前(deploy.sh:217) |
pnpm start:prod | 生产模式启动脚本 | spawn API 之前(scripts/start-prod.mjs:81-96) |
node dev-ops/post-deploy-knowledge.mjs | 手动 | 任意时刻 |
pnpm ops:knowledge:sync | pnpm 脚本别名 | 任意时刻(等价于上面那个手动入口) |
后两个是"运维手动补同步"用的——比如改了 help-docs md 之后只想补知识、不想重启 PM2。第一、第二个是"自动化",是默认应该走的路径。任何"改了知识但跳过了同步步骤"的部署都是事故——这不是流程纪律问题,是系统设计问题。
deploy.sh 内部用了 run_post_deploy_knowledge 函数(deploy.sh:211-219),与其它步骤顺序排列,但失败处理不同:知识同步失败会中止整个部署(脚本里没有 || true 兜底)。原因很简单:知识同步失败几乎必然意味着 apps/api/.env 配错或 DATABASE_URL 不通——这种状态下 PM2 启动也是白搭。
而 pnpm start:prod 这条路径里,post-deploy-knowledge 失败也是 process.exit(1),不留半成品环境。这两条路径的"严格"程度是不一样的——deploy.sh 是物理机 PM2,可以接受"先启动 PM2 再补知识"的流程;start-prod 是 Docker 容器模式,进程绑端口就是终态,所以严格到"知识同步失败 = 启动失败"。
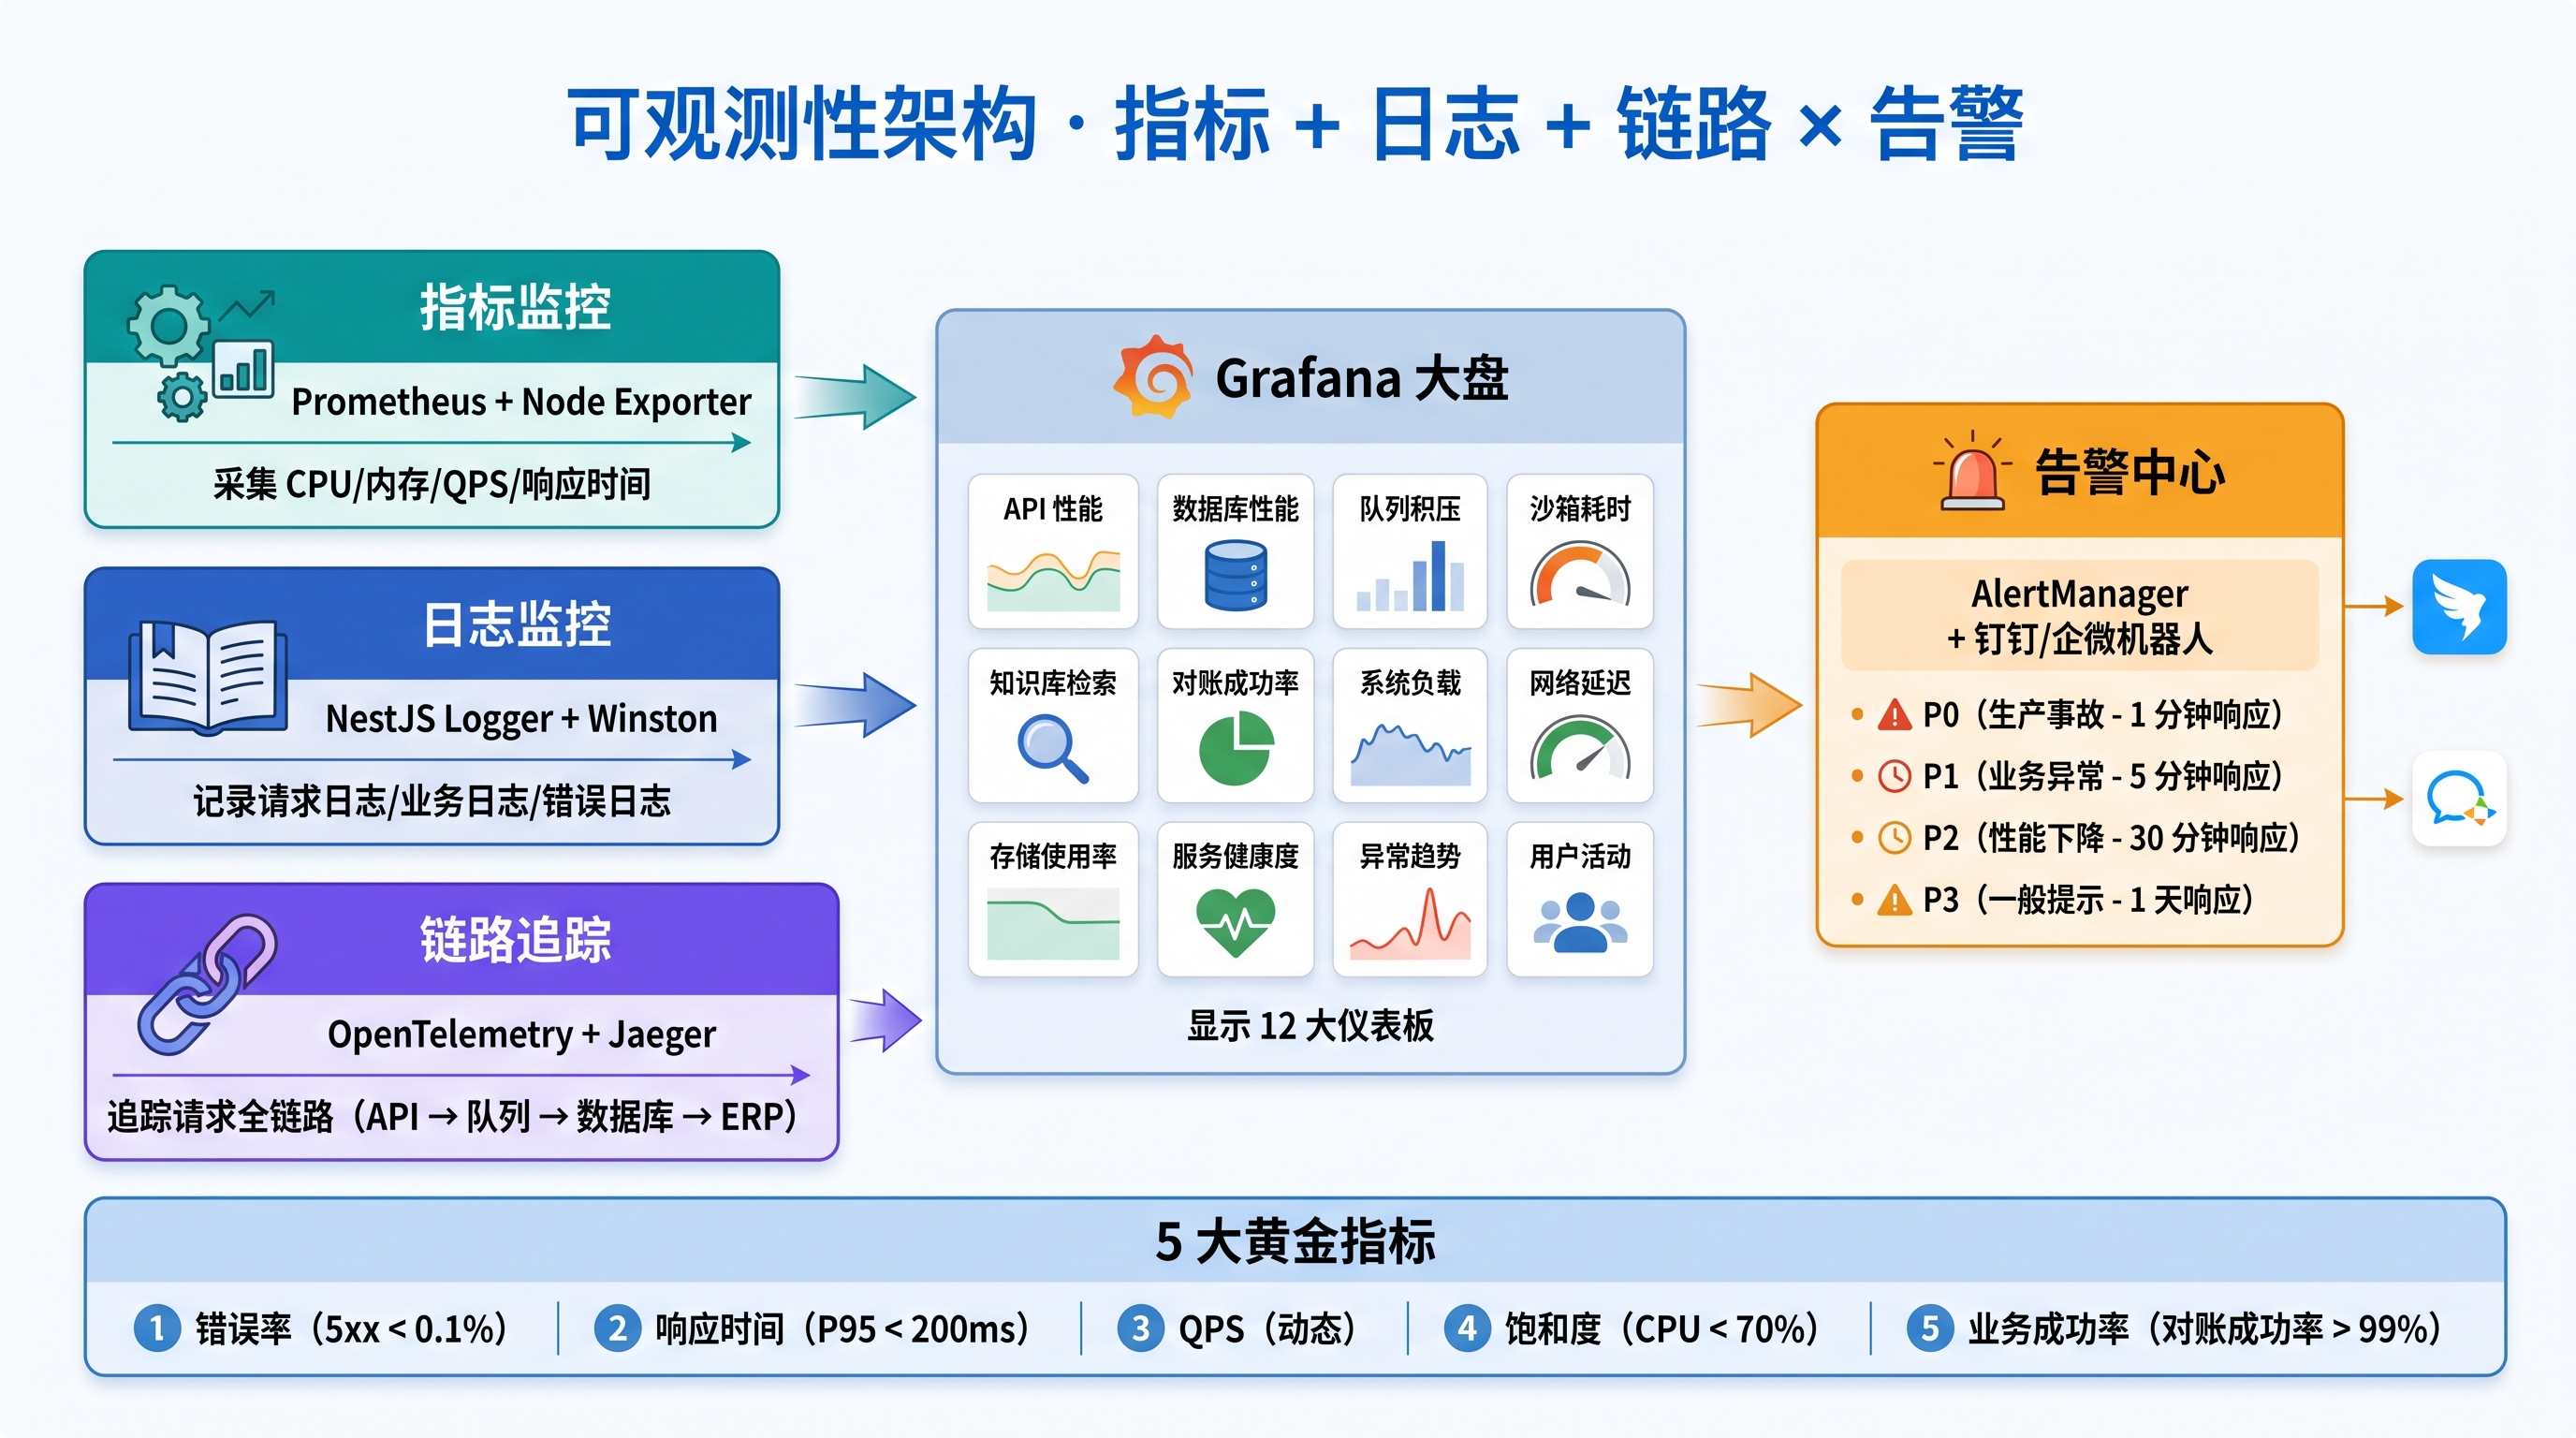
下面这张监控告警架构图展示了 post-deploy-knowledge 整个执行过程的可观测性——[INFO]/[OK]/[WARN]/[ERROR] 四级日志让运维一眼看出哪一步出问题:
五、踩坑与演进:知识库自动同步的三条经验
2026 年 9 月 20 日大清理之前,seeds 目录下有 8 个 seed 文件(users / shops / scripts / supply-orders / knowledge / help-docs-knowledge / parse-scripts / reconcile-scripts)。其中 scripts / supply-orders / parse-scripts / reconcile-scripts 这 4 个有"误清库风险"——它们要么写 deleteMany() 不带过滤,要么直接 prisma.user.deleteMany()。
大清理把它们全删了,原因不是它们写得"差",而是它们与"知识库同步"职责不符:scripts / supply-orders 应该走 import-scripts.mjs / 业务 API 维护,parse-scripts / reconcile-scripts 应该走沙箱试跑端点维护。让 seed 入口处理这些数据是"权力越界"。
经验一:种子文件应该按"职责"分桶,而不是按"实体"分桶。同一类职责的种子聚在一起(如知识库的两通道),跨职责的入口应该走 API / CLI / import-script 而不是 seed。这次清理的副作用是——post-deploy-knowledge 的"作用域"变得非常清晰:它只管知识库,其它东西它不动,也不需要懂。
经验二:run_post_deploy_knowledge 不能 set -e 友好地静默。deploy.sh 用了 set -euo pipefail,而 node dev-ops/post-deploy-knowledge.mjs 自己有 exit code 校验。中间一旦有一步失败(比如 apps/api/.env 不存在),脚本会以非零码退出,deploy.sh 立即停住后续的 PM2 restart——这是个好事,运维会马上看到错误日志。
经验三:embedding 失败写 1536 维全零向量是"工程上的温柔"。如果直接写 NULL,向量检索函数(pgvector HNSW)会把 NULL 当成"零距离"或者"无限远",导致召回结果完全错乱;写全零向量则让所有向量与它的距离都是固定值,被 embeddingStatus='ready' 过滤后这些失败的 chunk 不参与召回。一个看似不起眼的"全零向量"选择,背后是"绝不让坏数据污染好召回"的工程原则。
收尾:把"知识更新"变成部署的副作用
post-deploy-knowledge 这个机制的设计哲学可以浓缩成一句话:让知识更新变成部署的自然副作用,而不是需要单独记忆的步骤。
它用了三件事做到这一点:
- 入口收口——四个调用入口(deploy.sh / start-prod.mjs / 手动 / pnpm 别名)指向同一个 70 行的 Node 脚本,行为完全一致。
- 职责隔离——双通道种子只写 KnowledgeDocument / KnowledgeChunk,按 title/source 精确过滤,不碰其他表。
- 最终一致——embedding 由 API bootstrap fire-and-forget 补算,失败写 1536 维全零向量兜底,部署不被任何 embedding 调用阻塞。
轻易云智能对账系统在 AI 工程完整度上的一个体现,就是这种"部署即知识库同步"的纪律——它不是炫技,而是把"运维不需要知道这次改的是 md 还是 seed"这件事变成工程约束而不是口头约定。SRE 在部署时不需要问"我改了 help-docs.md 是不是要再跑一次 embed"——bash dev-ops/deploy.sh 一行就够。
如果你正在维护一套 AI 系统,遇到"知识库版本与代码版本漂移"的反复困扰,post-deploy-knowledge 这套机制值得抄一份:70 行的脚本 + 一份部署纪律,省下的是"每次上线都要想一下知识有没有同步"的人工开销。
更深入的 AI 财务智能体设计与 RAG 知识库工程实践,可参见项目内的 AI Agent 开发指南与帮助文档内容维护规范两份核心文档——它们对"SKILL 装契约、知识库装例子"这条原则做了完整展开。